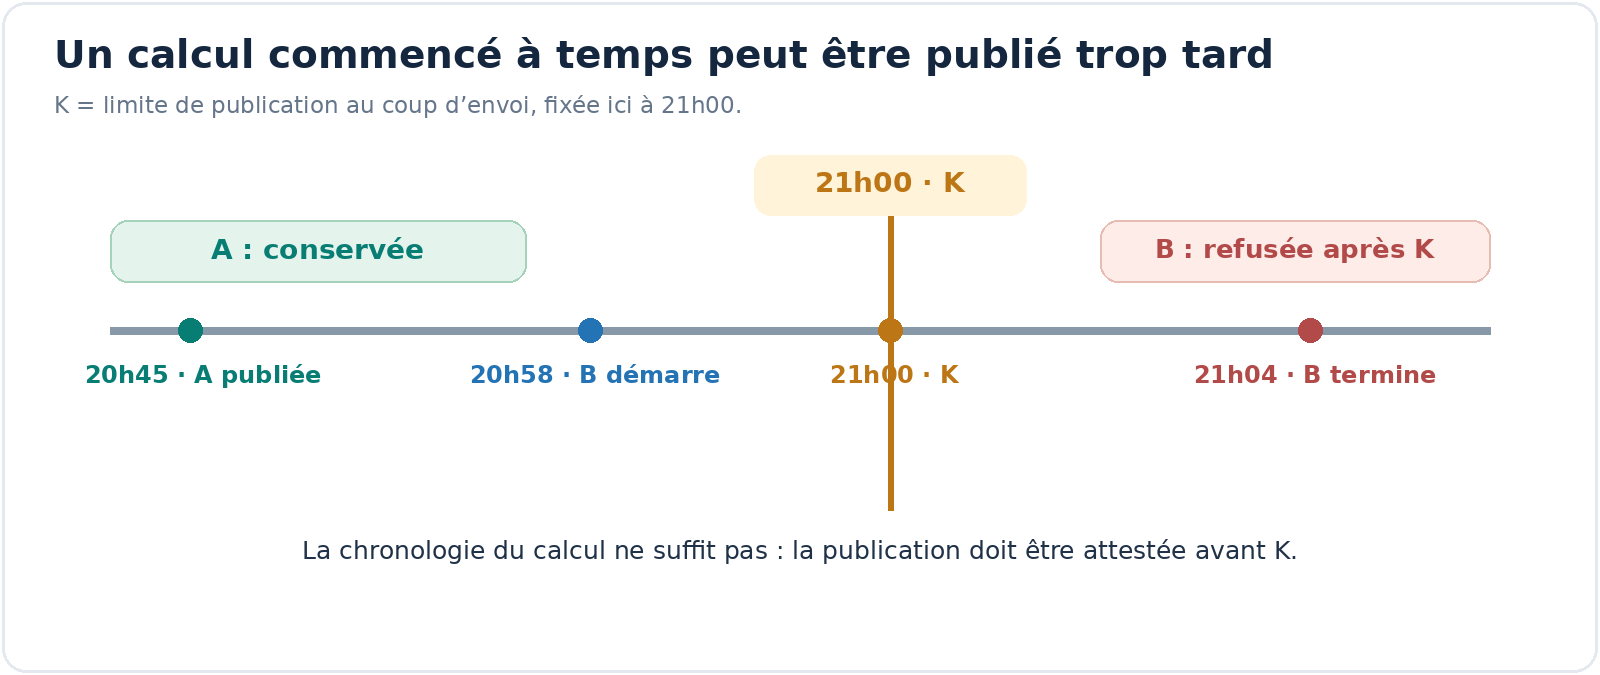
20 h 58 : le calcul commence. 21 h 04 : il est déjà trop tard.
Un match commence à 21 heures. À 20 h 45, un premier pronostic est publié. À 20 h 58, un programme lance une nouvelle analyse, qui se termine à 21 h 04. Quelle version doit compter dans l’historique ?
La première. Le nouveau calcul a bien démarré avant le coup d’envoi, mais son résultat n’était pas disponible à temps. Le présenter ensuite comme un pronostic d’avant-match changerait ce qui avait réellement été proposé.
Ce scénario fictif résume une difficulté très concrète des prédictions sportives : commencer à calculer avant le match ne suffit pas. Il faut aussi avoir publié avant son début.
 Agrandir le schéma dans un nouvel onglet
Ce problème ne concerne pas seulement les modèles de football. Il existe chaque fois qu’on veut évaluer une décision passée : une prévision météo, une estimation de ventes ou une prédiction financière. La question reste la même : qu’était-il réellement possible de savoir à cet instant ?
Le temporal leakage, ou le futur qui s’invite dans le passé
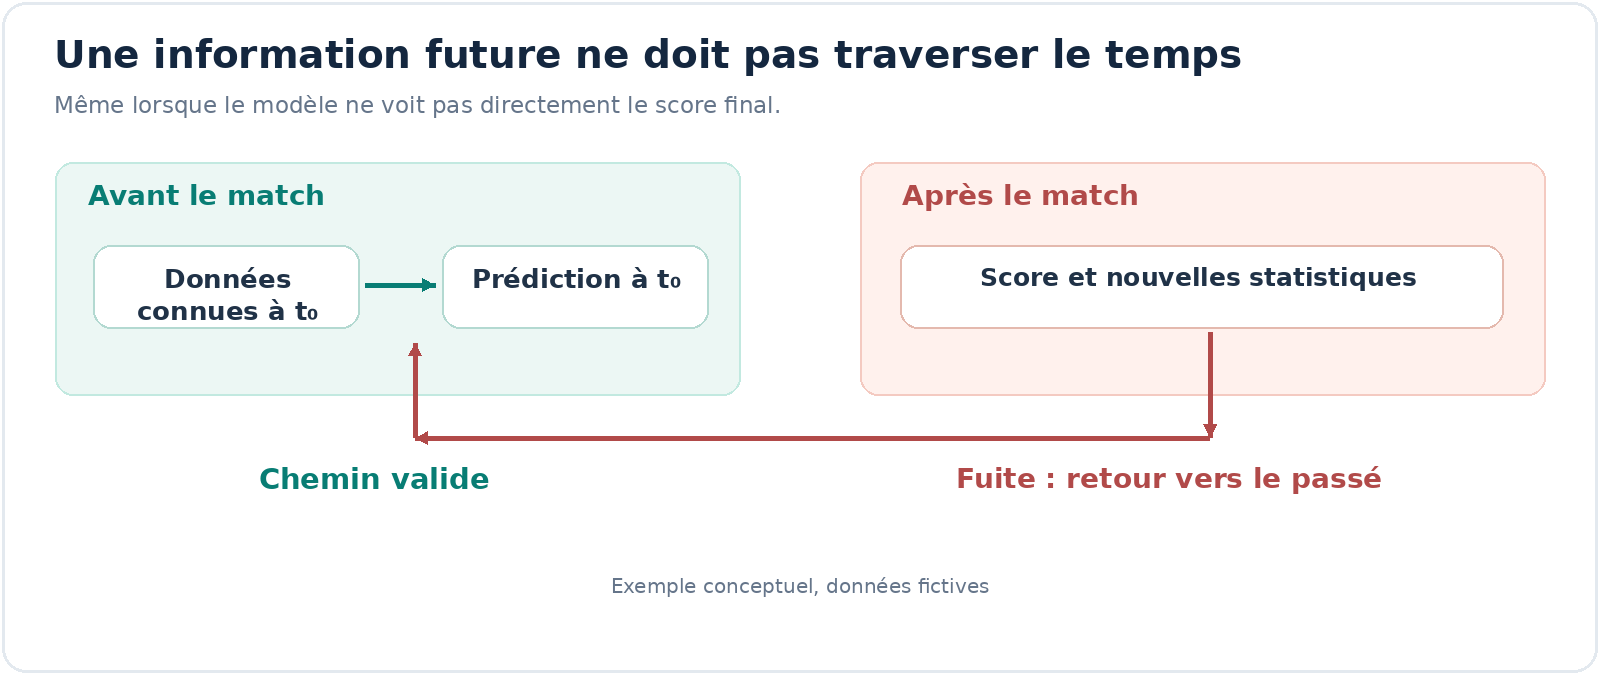
Imaginons que l’on recalcule aujourd’hui le pronostic d’un match joué dimanche dernier. Le score est connu, le classement a changé et les statistiques des équipes ont été actualisées. Le programme peut produire un chiffre, mais celui-ci ne représente plus nécessairement ce qu’il aurait annoncé avant la rencontre.
C’est le principe de la fuite temporelle, souvent appelée temporal leakage : une information indisponible au moment de la prédiction influence son calcul ou son évaluation.
Il n’est même pas nécessaire d’utiliser directement le score final. Une moyenne de buts qui inclut déjà le match étudié, un classement actualisé après son résultat ou une cote recueillie trop tard peuvent suffire.
 Agrandir le schéma dans un nouvel onglet
La limite n’est d’ailleurs pas toujours le coup d’envoi. Si l’on veut évaluer un pronostic publié à 18 heures, une information reçue à 20 heures est déjà trop récente pour reconstruire ce pronostic, même si le match commence à 21 heures.
Trois risques se rencontrent ainsi : utiliser des données futures, remplacer une ancienne prédiction par un calcul récent, ou appliquer de nouveaux critères pour choisir après coup les « bons » matchs du passé. Ils peuvent rendre un bilan plus flatteur sans améliorer la capacité à prévoir les prochaines rencontres.
Calculé, enregistré, publié : trois moments différents
L’heure indiquée sur une prédiction mérite donc une question : que représente-t-elle ? Le début du calcul, sa fin, l’enregistrement d’un fichier ou la mise à disposition du résultat ? Ces événements peuvent être séparés de plusieurs minutes.
Reprenons notre calcul de 20 h 58. Même si toutes ses données étaient figées au départ, un résultat publié à 21 h 04 ne devient pas un pronostic accessible à 20 h 58. L’heure du lancement ne peut pas servir à antidater la publication.
Il faut donc contrôler la situation à la fin du traitement, au moment de publier. Si la limite a été dépassée, la nouvelle version ne doit pas remplacer celle qui était déjà disponible. Sans version antérieure, il faut accepter l’absence de pronostic.
Et si l’enregistrement traverse lui-même le coup d’envoi ?
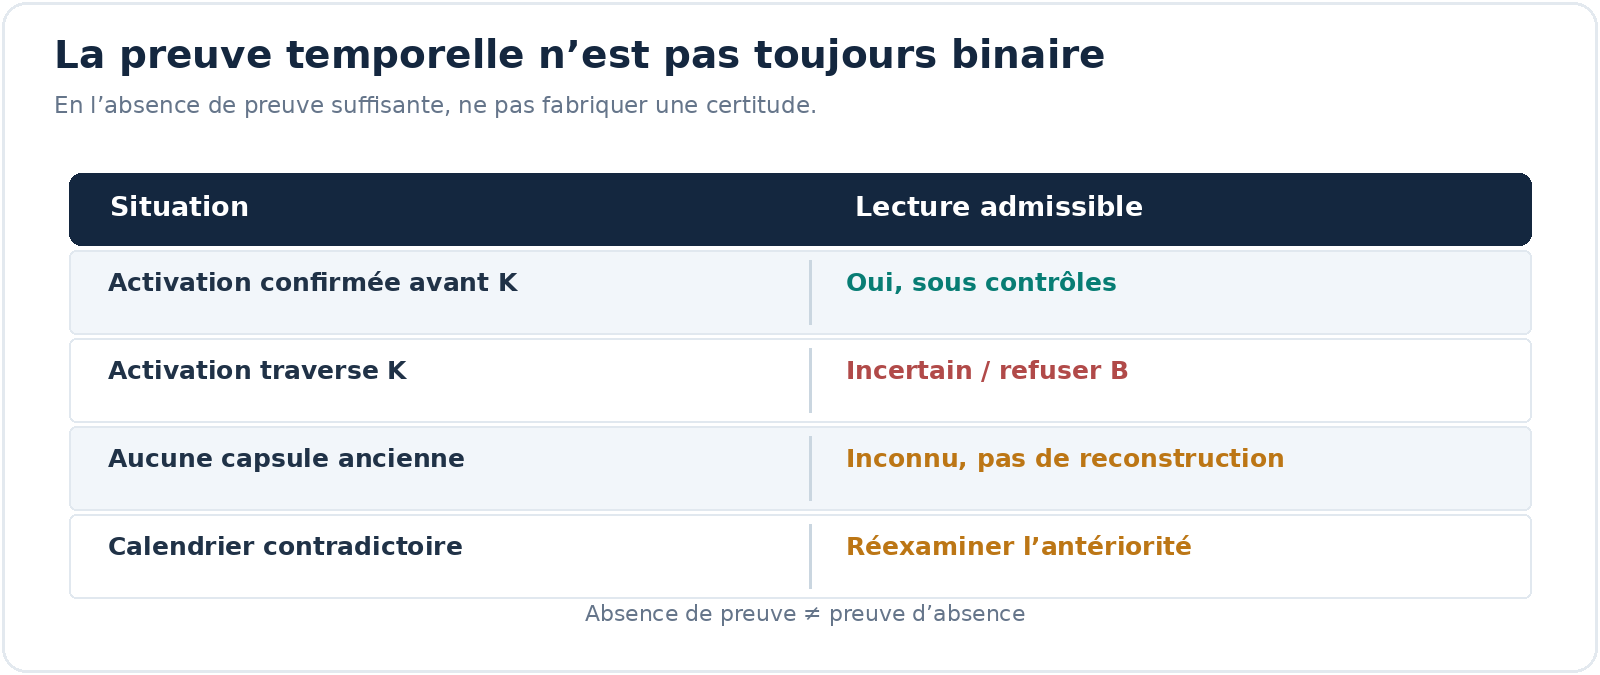
Une opération peut commencer juste avant 21 heures et ne se terminer que quelques instants après. Si l’on ne peut pas établir qu’elle était achevée avant le début du match, il faut conserver cette incertitude et refuser de présenter la nouvelle version comme un pronostic d’avant-match confirmé.
La même prudence s’applique à une interruption du programme. Retrouver un résultat au redémarrage ne suffit pas à prouver qu’il avait été publié à temps.
Le score évolue. Le pronostic conservé reste le même.
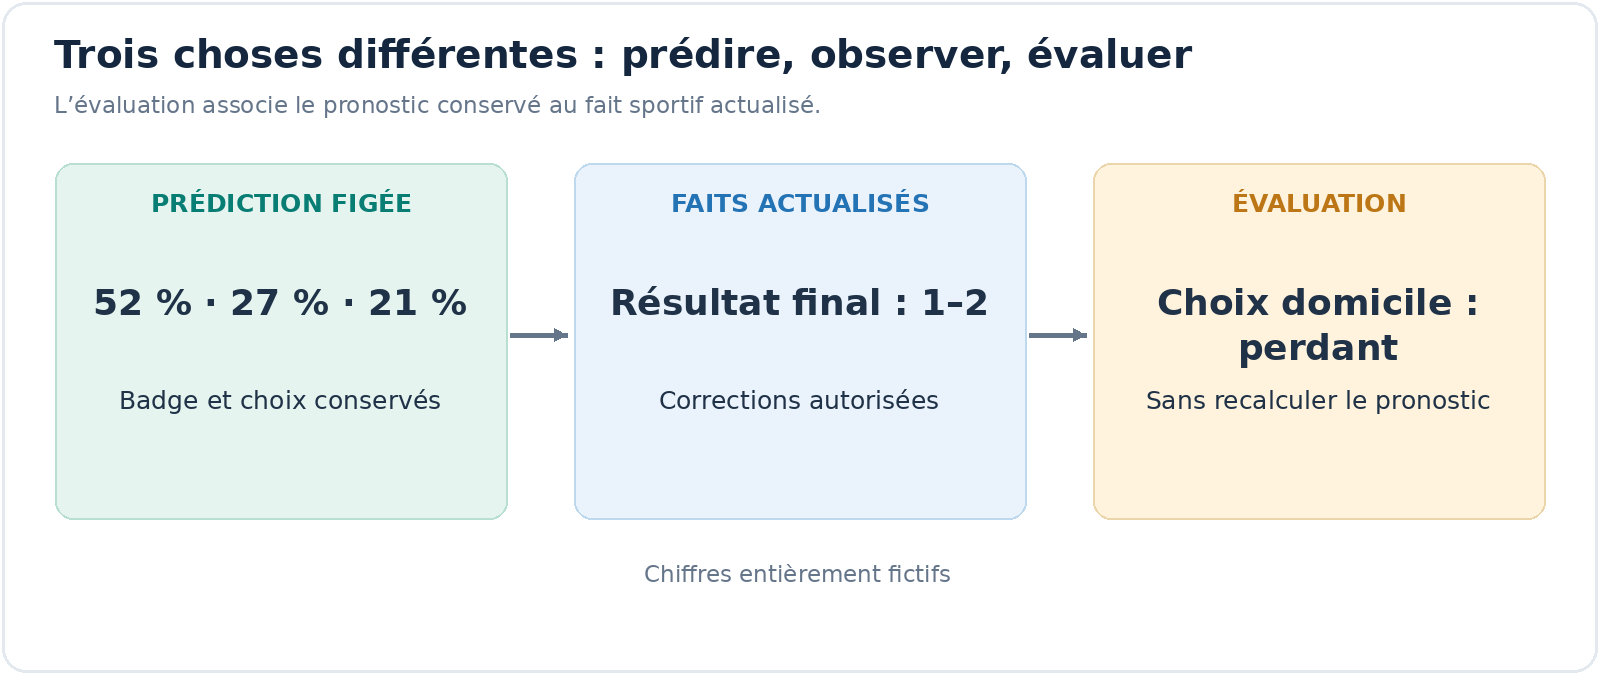
Un historique utile associe deux choses : ce qui avait été prédit et ce qui s’est réellement passé. Le résultat final arrive après la rencontre ; il doit naturellement pouvoir être ajouté ou corrigé. Cela ne justifie pas de recalculer les probabilités d’origine.
Prenons un exemple fictif : 52 % de victoire à domicile, 27 % de match nul et 21 % de victoire à l’extérieur. Le match se termine sur le score de 1–2. Le choix domicile est perdant ; la distribution initiale reste celle qui doit être évaluée.
 Agrandir le schéma dans un nouvel onglet
Une défaite ne prouve pas, à elle seule, que la probabilité de 52 % était mauvaise. Elle rappelle qu’une probabilité n’est pas une certitude. Sa fiabilité se mesure sur un ensemble de situations comparables, comme nous l’expliquons dans notre article sur la calibration des probabilités.
Les badges et les sélections font aussi partie de l’histoire
Conserver les chiffres ne suffit pas si de nouveaux seuils changent ensuite la liste des anciens matchs présentés comme les « meilleurs pronostics ». Il faut aussi préserver les décisions qui accompagnaient la publication : marché retenu, badge attribué et appartenance à une sélection.
Tester une nouvelle règle sur les rencontres passées reste utile. Il faut simplement identifier ce travail comme une simulation rétrospective, distincte de ce qui avait été proposé à l’époque.
Les reports et les horaires demandent aussi de la prudence
Un match peut être retardé ou reprogrammé. Un fournisseur peut corriger son calendrier ou signaler le début du jeu plus tard que prévu. Il faut traiter ces informations sans faire disparaître la chronologie précédente.
Un report connu avant l’échéance peut permettre d’adapter les prochaines publications. Un report découvert après l’ancienne heure de début ne doit pas, à lui seul, autoriser la réouverture automatique des pronostics. Ce choix prudent peut conduire à ne pas proposer de nouvelle version pour une rencontre reprogrammée.
Les fuseaux horaires ajoutent une difficulté : 21 heures à Paris et 21 heures à Londres ne désignent pas le même instant. Lors des changements d’heure, certaines heures locales existent même deux fois. Les comparaisons doivent donc reposer sur un instant précis, avec son fuseau, et pas uniquement sur une heure affichée.
Il faut enfin distinguer le moment où un fait s’est produit et celui où il a été appris. Une correction reçue lundi à propos d’un match du dimanche ne faisait pas partie des connaissances disponibles dimanche.
Comment Foresportia prend ces risques en compte
Chez Foresportia, nous avons intégré ces situations aux contrôles des pronostics. L’objectif est de conserver une mémoire fidèle de ce qui avait été proposé, tout en continuant à actualiser les résultats sportifs.
- Vérifier le bon match et son horaire. Une rencontre doit être identifiée sans ambiguïté, et un changement de calendrier doit être pris en compte.
- Contrôler la fin du traitement. Un nouveau calcul ne doit pas remplacer les valeurs antérieures si le match a commencé pendant son exécution.
- Conserver les décisions publiées. Les probabilités, les badges et les sélections doivent garder leur sens historique lorsque les modèles et les règles évoluent.
- Actualiser séparément les faits sportifs. Ajouter un score sert à évaluer le pronostic, pas à le réécrire.
- Tester les situations difficiles. Des tests automatisés simulent notamment le franchissement du coup d’envoi, des valeurs anciennes partielles et une archive précédente illisible.
Ces contrôles ne rendent pas les matchs plus prévisibles. Ils servent à ce que l’évaluation porte sur les prédictions conservées, y compris celles qui se sont trompées.
Une donnée inconnue doit parfois rester inconnue
Une ancienne valeur peut manquer, ou avoir été retrouvée sans preuve suffisante de sa publication avant le match. Ce sont deux situations différentes, qui ne se résolvent pas en relançant le modèle actuel.
Ajouter un nouveau marché aujourd’hui ne permet pas non plus de prétendre qu’il était proposé il y a six mois. Un historique peut comporter des absences et des niveaux de preuve différents, notamment dans ses données les plus anciennes.
 Agrandir le schéma dans un nouvel onglet
Il faut donc accepter de répondre « inconnu » lorsque les éléments disponibles ne permettent pas de conclure. À l’inverse, l’absence d’une ligne dans une archive ne démontre pas automatiquement qu’aucun pronostic n’a jamais été publié.
Un enregistrement protégé doit conserver ses valeurs ; une contradiction découverte ensuite doit rester visible. La transparence consiste aussi à garder ces limites, plutôt qu’à rendre artificiellement l’historique complet.
Conserver les pronostics ne dispense pas de vérifier les données
Un pronostic parfaitement archivé peut avoir été calculé avec une information trop récente. La prévention des fuites temporelles commence donc aussi avant la publication.
Pour évaluer un modèle, on doit le confronter à des matchs plus récents que ceux utilisés pour l’entraîner, calculer la forme d’une équipe sans inclure le match à prévoir et vérifier quand chaque information était réellement disponible.
Des séparations chronologiques et des statistiques fondées sur les rencontres précédentes font partie des précautions présentes dans nos traitements d’apprentissage. Elles complètent les contrôles de publication ; elles ne remplacent pas l’examen des sources, des corrections tardives et des différentes variables utilisées.
La documentation de scikit-learn sur les fuites de données présente ce principe général : l’évaluation ne doit pas bénéficier d’informations indisponibles au moment de prédire.
Un historique crédible conserve aussi les erreurs
Un bon pronostic mis en avant ne suffit pas à juger un modèle. Ce qui compte, c’est de pouvoir comparer ses propositions aux résultats, sur la durée, sans changer les règles du passé après avoir vu les scores.
Refuser un calcul tardif, conserver une sélection perdante ou laisser une donnée inconnue demande parfois de renoncer à un bilan plus complet en apparence. C’est pourtant ce qui permet de l’interpréter correctement.
Une prédiction doit pouvoir se tromper. Son historique doit permettre de le constater.
Les questions fréquentes
Qu’est-ce que le temporal leakage ?
C’est l’utilisation d’une information qui n’était pas disponible au moment de la prédiction. Elle peut fausser le calcul ou son évaluation historique.
Un calcul commencé avant le match est-il forcément un pronostic d’avant-match ?
Non. Il faut aussi que sa version ait été publiée avant le coup d’envoi. L’heure de lancement ne suffit pas à démontrer cette antériorité.
Pourquoi le résultat peut-il changer sans modifier le pronostic ?
Le score est un fait sportif actualisé après le match. Les probabilités et les décisions conservées servent de référence pour évaluer ce résultat.
Conserver les pronostics garantit-il leur réussite ?
Non. Ces contrôles protègent la fidélité de l’historique ; ils ne suppriment pas l’incertitude du football.